
Умный фильтр 1С-Битрикс и SEO: ЧПУ, индексация, canonical и посадочные без тысяч дублей
Умный фильтр помогает покупателю быстро найти товар, но для поискового робота тот же механизм способен породить десятки тысяч URL, дубли метатегов, бесполезный обход и конкурирующие посадочные страницы. Разбираем, как построить фильтрацию на 1С-Битрикс так, чтобы она одновременно была удобной пользователю, быстрой для большого каталога и управляемой с точки зрения Google и Яндекса.
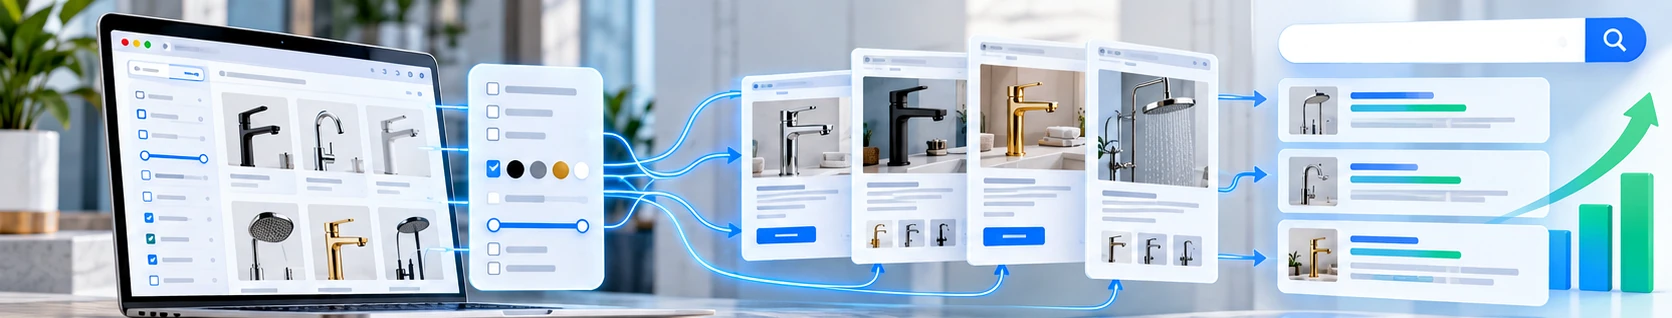
1. Как устроен умный фильтр 1С-Битрикс
Стандартный компонент bitrix:catalog.smart.filter формирует условия отбора элементов каталога и
передаёт их компоненту списка товаров. Он умеет работать со свойствами товаров и торговых предложений,
показывать количество найденных позиций и поддерживает ЧПУ через SEF_MODE,
SEF_RULE и SMART_FILTER_PATH.
В современных версиях 1С-Битрикс фильтр использует фасетный поиск. Система заранее строит индекс по свойствам, чтобы при изменении параметров не перебирать весь каталог линейно. Это особенно важно для магазинов с десятками тысяч товаров и большим количеством характеристик.
<?
$APPLICATION->IncludeComponent(
    "bitrix:catalog.smart.filter",
    ".default",
    [
        "IBLOCK_TYPE" => "catalog",
        "IBLOCK_ID" => $arParams["IBLOCK_ID"],
        "SECTION_ID" => $arResult["VARIABLES"]["SECTION_ID"],
        "SECTION_CODE" => $arResult["VARIABLES"]["SECTION_CODE"],
        "FILTER_NAME" => $arParams["FILTER_NAME"],
        "PRICE_CODE" => $arParams["PRICE_CODE"],

        "CACHE_TYPE" => "A",
        "CACHE_TIME" => "36000000",

        "SEF_MODE" => "Y",
        "SEF_RULE" => $arResult["FOLDER"]
            . $arResult["URL_TEMPLATES"]["smart_filter"],
        "SMART_FILTER_PATH" =>
            $arResult["VARIABLES"]["SMART_FILTER_PATH"],

        "DISPLAY_ELEMENT_COUNT" => "Y",
    ]
);
?>?arrFilter_.... Сначала нужна политика индексации, потом ЧПУ.
2. Почему один фильтр создаёт десятки тысяч URL
Главная проблема фасетной навигации — комбинаторика. Каждый новый набор значений потенциально становится отдельным адресом. Google прямо называет фасетную навигацию одним из наиболее частых источников избыточного сканирования: робот тратит ресурсы на URL, которые не имеют поисковой ценности, и медленнее обнаруживает важные новые страницы.
Как возникает «взрыв URL»
Даже небольшой набор фильтров очень быстро превращается в огромную матрицу комбинаций.
На практике URL-пространство может стать значительно больше, потому что значения комбинируются между собой в разном порядке, к ним добавляются сортировки, пагинация, вид отображения, диапазоны цены, UTM-метки и служебные параметры.
Задача SEO — не «запретить фильтр», а отделить полезные поисковые страницы от технических состояний интерфейса.
3. Какие фильтры индексировать, а какие нет
Универсального правила «бренд индексируем, цвет закрываем» нет. Решение принимают по трём критериям: существует ли самостоятельный поисковый спрос, есть ли достаточный ассортимент и можно ли сформировать страницу, которая отличается от родительской категории не только набором товаров.
| Комбинация | Типичное решение | Почему |
|---|---|---|
| Категория + популярный бренд | Индексировать | Часто существует отдельный коммерческий спрос: «смесители Grohe». |
| Категория + значимое свойство | По спросу | Например «чёрные смесители» может быть полноценной посадочной, если есть ассортимент. |
| Бренд + популярное свойство | По спросу | Нужно проверить семантику и объём каталога. |
| Цена от / до | Не индексировать | Диапазонов бесконечно много, спрос обычно не совпадает с точными границами фильтра. |
| Наличие | Не индексировать | Состояние быстро меняется и редко создаёт самостоятельную поисковую ценность. |
| Сортировка, плитка / список | Не индексировать | Контент тот же, меняется только порядок или представление. |
| Случайная комбинация 4–6 свойств | Не индексировать | Обычно слишком узкая страница без спроса, часто с 1–2 товарами. |
Матрица принятия решения
Индексировать стоит не «фильтр», а конкретную комбинацию, прошедшую отбор.
- есть подтверждённый поисковый спрос;
- достаточно товаров;
- URL стабилен;
- есть уникальные H1, Title и Description;
- есть self-canonical;
- на страницу ведут внутренние ссылки;
- она добавлена в sitemap.
- это сортировка или вид списка;
- комбинация создаётся случайно;
- спроса нет;
- товаров мало или результат пуст;
- контент полностью дублирует категорию;
- параметр технический или рекламный;
- URL может измениться после обмена.
4. Архитектура, которую мы считаем наиболее управляемой
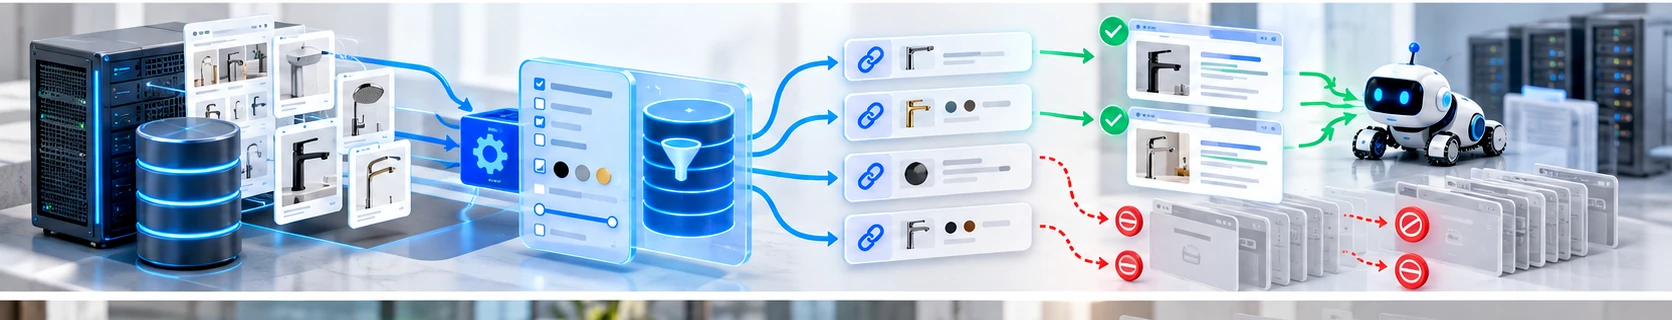
Для серьёзного интернет-магазина лучше не пытаться заставить стандартный фильтр самостоятельно решать, что достойно индексации. Надёжнее разделить систему на три уровня.
Три слоя фильтрации
Пользовательская фильтрация остаётся гибкой, а SEO-слой управляется отдельно.
5. ЧПУ умного фильтра: что важно кроме красивого адреса
Официальный компонент 1С-Битрикс поддерживает ЧПУ через SEF_MODE. Типовой адрес выглядит
примерно так:
/catalog/#SECTION_CODE_PATH#/filter/#SMART_FILTER_PATH#/apply/Главное — добиться детерминированности. Одна комбинация свойств должна иметь один нормальный адрес.
ХОРОШО
/catalog/smesiteli/filter/brand-is-grohe/apply/

ПЛОХО — если обе версии отдают 200 и один контент
/catalog/smesiteli/filter/brand-is-grohe/color-is-black/apply/
/catalog/smesiteli/filter/color-is-black/brand-is-grohe/apply//filter/ в robots.txt, если вы хотите продвигать хотя бы часть
ЧПУ-фильтров. Такое правило отрежет поисковому роботу и полезные SEO-посадочные.
6. Canonical: где он помогает, а где ломает SEO-посадочную
Canonical нужен для объединения одинаковых или очень похожих URL. Он не должен использоваться как универсальная кнопка «эту страницу не хочу видеть в поиске».
Как выбирать canonical
Сначала решаем, является ли фильтр самостоятельной поисковой страницей.
Self-canonical на текущий URL.
Переходим к следующему вопросу.
Canonical на наиболее близкую основную страницу.
Если страница не нужна в поиске — noindex.
<?
$canonical = "https://example.ru/catalog/smesiteli/filter/brand-is-grohe/apply/";

$APPLICATION->AddHeadString(
    '<link rel="canonical" href="' . htmlspecialchars(
        $canonical,
        ENT_QUOTES | ENT_SUBSTITUTE,
        "UTF-8"
    ) . '">',
    true
);
?>Google рекомендует использовать self-canonical на индексируемых страницах и не смешивать противоречащие друг другу сигналы: например, не указывать один URL в sitemap, а другой — через canonical.
7. robots.txt: рабочая база для служебных параметров
robots.txt управляет сканированием, а не гарантированным удалением URL из индекса.
Если URL уже известен поисковой системе, запрет обхода может привести к ситуации, когда адрес останется в
поиске без нормального сниппета, потому что робот не сможет прочитать noindex.
User-agent: *
Disallow: /*?sort=
Disallow: /*&sort=
Disallow: /*?order=
Disallow: /*&order=
Disallow: /*?view=
Disallow: /*&view=
Disallow: /*?display=
Disallow: /*&display=
Disallow: /*?PAGEN_
Disallow: /*&PAGEN_
Disallow: /*?SHOWALL_
Disallow: /*&SHOWALL_

User-agent: Yandex
Disallow: /*?sort=
Disallow: /*&sort=
Disallow: /*?order=
Disallow: /*&order=
Disallow: /*?view=
Disallow: /*&view=
Disallow: /*?display=
Disallow: /*&display=
Disallow: /*?PAGEN_
Disallow: /*&PAGEN_
Disallow: /*?SHOWALL_
Disallow: /*&SHOWALL_

Clean-param: utm_source&utm_medium&utm_campaign&utm_content&utm_term
Clean-param: from&yclid&gclid

Sitemap: https://example.ru/sitemap.xmlUser-agent: Yandex, общие правила
из User-agent: * для него не наследуются автоматически. Поэтому нужные Disallow продублированы.
8. noindex: когда URL можно обходить, но нельзя показывать в поиске
Для комбинаций фильтра, которые доступны пользователю, но не должны становиться поисковыми страницами,
удобно использовать noindex, follow. Робот может прочитать страницу и перейти по ссылкам,
но URL не должен участвовать в поиске.
<?
if ($isFilterPage && !$isSeoLanding)
{
    $APPLICATION->SetPageProperty(
        "robots",
        "noindex, follow"
    );
}
?>
Для файлов или ответов, где нет HTML <head>, можно использовать HTTP-заголовок:
X-Robots-Tag: noindex, follownoindex:
если бот не может скачать страницу, он не увидит метатег. Для уже проиндексированных URL сначала логичнее
разрешить обход и отдать noindex, а после удаления из поиска при необходимости ограничивать crawl.
9. Пустая комбинация фильтра: 200, noindex или 404?
Google рекомендует возвращать 404 для бессмысленных или несуществующих комбинаций фасетов. Например, если URL содержит два взаимоисключающих значения или параметр, которого вообще нет в каталоге.
Но есть нюанс: если это стабильная SEO-посадочная, которая временно осталась без товара, автоматический 404 может быть ошибкой. Для таких страниц решение зависит от бизнес-логики: иногда полезнее сохранить страницу с альтернативами или временно использовать noindex.
<?
use Bitrix\Iblock\Component\Tools;

if ($isFilterPage && $resultCount === 0 && !$isSeoLanding)
{
    Tools::process404(
        "Ничего не найдено",
        true,
        true,
        true,
        false
    );
}
?>
Tools::process404() — штатный D7-метод модуля информационных блоков. Здесь он задаёт
статус 404, константу ERROR_404 и выводит стандартную страницу /404.php.
10. Яндекс: Clean-param и настройка GET-параметров
Яндекс отдельно поддерживает директиву Clean-param. Она подходит для параметров, которые не
меняют содержимое страницы: рекламные метки, источники перехода и другие технические значения.
User-agent: Yandex
Clean-param: utm_source&utm_medium&utm_campaign&utm_content&utm_term
Clean-param: from&yclid&gclid
С конца 2025 года в Яндекс Вебмастере также есть отдельный инструмент управления GET-параметрами: Индексирование → Настройка GET-параметров. Там можно указать, влияет ли параметр на содержимое и должен ли URL участвовать в поиске.
brand=grohe показывает другой ассортимент, объявлять его «незначимым» нельзя.
11. Как превратить полезную комбинацию фильтра в SEO-посадочную
Индексируемая страница фильтра должна выглядеть для поисковой системы как полноценная посадочная, а не как случайное состояние формы. Минимально ей нужны стабильный URL, собственный H1, Title, Description, self-canonical, ассортимент, внутренняя ссылка и место в sitemap.
Что должна получить SEO-посадочная
Лучше хранить эти данные в отдельном реестре, а не пытаться генерировать всё из выбранных галочек.
<?
$seoPage = [
    "H1" => "Смесители Grohe",
    "TITLE" => "Смесители Grohe — купить в интернет-магазине",
    "DESCRIPTION" =>
        "Смесители Grohe: актуальный каталог, характеристики, цены и наличие.",
    "CANONICAL" =>
        "https://example.ru/catalog/smesiteli/filter/brand-is-grohe/apply/",
];

$APPLICATION->SetTitle($seoPage["H1"]);
$APPLICATION->SetPageProperty("title", $seoPage["TITLE"]);
$APPLICATION->SetPageProperty(
    "description",
    $seoPage["DESCRIPTION"]
);

$APPLICATION->SetPageProperty(
    "robots",
    "index, follow, max-image-preview:large"
);

$APPLICATION->AddHeadString(
    '<link rel="canonical" href="'
    . htmlspecialchars(
        $seoPage["CANONICAL"],
        ENT_QUOTES | ENT_SUBSTITUTE,
        "UTF-8"
    )
    . '">',
    true
);
?>
12. Sitemap: включаем только те фильтры, которые хотим видеть в поиске
Sitemap — это ещё один сигнал согласованности. Если SEO-посадочная индексируема и имеет self-canonical, её логично добавить в sitemap. Неиндексируемые фильтры туда попадать не должны.
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
    <url>
        <loc>https://example.ru/catalog/smesiteli/</loc>
        <lastmod>2026-09-28</lastmod>
    </url>

    <url>
        <loc>https://example.ru/catalog/smesiteli/filter/brand-is-grohe/apply/</loc>
        <lastmod>2026-09-28</lastmod>
    </url>
</urlset>
Если посадочных много, удобнее создать отдельный файл:
<?xml version="1.0" encoding="UTF-8"?>
<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
    <sitemap>
        <loc>https://example.ru/sitemap-catalog.xml</loc>
    </sitemap>

    <sitemap>
        <loc>https://example.ru/sitemap-seo-filter.xml</loc>
    </sitemap>
</sitemapindex><?
$pages = [
[
"URL" =>
"https://example.ru/catalog/smesiteli/filter/brand-is-grohe/apply/",
"LASTMOD" => "2026-09-28",
"ACTIVE" => true,
],
[
"URL" =>
"https://example.ru/catalog/smesiteli/filter/color-is-black/apply/",
"LASTMOD" => "2026-09-25",
"ACTIVE" => true,
],
];
header("Content-Type: application/xml; charset=UTF-8");
echo '<?xml version="1.0" encoding="UTF-8"?>';
echo '<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">';
foreach ($pages as $page)
{
if (!$page["ACTIVE"])
{
continue;
}
echo "<url>";
echo "<loc>"
. htmlspecialchars($page["URL"], ENT_XML1 | ENT_QUOTES, "UTF-8")
. "</loc>";
echo "<lastmod>"
. htmlspecialchars($page["LASTMOD"], ENT_XML1 | ENT_QUOTES, "UTF-8")
. "</lastmod>";
echo "</url>";
}
echo "</urlset>";
?>13. Фасетный индекс: SEO начинается со скорости фильтра
В 1С-Битрикс фасетный индекс создаётся для торгового каталога и используется умным фильтром для быстрого отбора. Официальная документация рекомендует сначала окончательно настроить свойства, которые участвуют в фильтрации, а затем строить индекс; при изменении состава фильтруемых свойств индекс может потребовать пересоздания.
<?
use Bitrix\Iblock\PropertyIndex\Manager;

$iblockId = 2;
$productId = 12345;

Manager::updateElementIndex(
    $iblockId,
    $productId
);
?>14. Что меняется на каталоге со 100 000+ товаров
Чем больше каталог, тем опаснее подход «сначала откроем всё, потом разберёмся». На крупных проектах стоимость ошибки измеряется не только индексом поисковой системы, но и нагрузкой на PHP, БД, кеш, обмены с 1С и временем обхода роботов.
Для большого каталога мы бы разделили ответственность:
| Уровень | Что контролируем |
|---|---|
| Данные | Стабильные коды свойств, типы значений, SKU, обмен с 1С. |
| Фильтр | Какие свойства показываем, фасетный индекс, скорость, AJAX. |
| URL | Единый порядок, отсутствие дублей, 404 невозможных сочетаний. |
| SEO-реестр | Разрешённые посадочные, метаданные, canonical, sitemap. |
| Мониторинг | Логи роботов, Search Console, Яндекс Вебмастер, ошибки и новые параметры. |
15. Перелинковка: как встроить фильтры в структуру сайта
SEO-посадочная не должна существовать только потому, что робот однажды нашёл ссылку в форме фильтра. Если страница действительно важна, на неё нужно вести обычными HTML-ссылками из логичных мест сайта.
Куда связывать эту тему на Nova Sphere
Эта статья становится частью технического SEO-кластера и одновременно подтверждает экспертизу в разработке.
Отсюда читатель может перейти к общей стратегии: технический аудит, семантика, контент, ссылки и аналитика.
Полное руководство по SEO-продвижению сайта →Коммерческий следующий шаг для владельца магазина, которому нужна диагностика и внедрение.
SEO-оптимизация и привлечение целевой аудитории →Фильтр часто упирается не в тексты, а в архитектуру каталога, шаблон компонента и обмен данными.
Разработка сайта любой сложности →Контекстная ссылка на платформу и лицензии, для которой разбирается компонент.
Перейти в раздел 1С-Битрикс →Обратные ссылки на материал стоит добавить из первой SEO-статьи и из кейсов, где фильтрация была частью реальной разработки. Это помогает и пользователю, и поисковому роботу понять, что перед ним не изолированная публикация, а часть экспертизы компании.
16. Как найти уже существующие дубли фильтра
До внедрения новой схемы сначала нужно понять, что поисковые системы уже успели увидеть. Обычно полезны четыре источника: логи веб-сервера, Google Search Console, Яндекс Вебмастер и собственный краулер.
/filter/, ? и параметрами сортировки из логов.grep -E '(/filter/|\?[^ ]*(sort|order|view|PAGEN_))' access.log \
| awk '{print $7}' \
| sort \
| uniq -c \
| sort -nr \
| head -10017. Почему эта тема для Nova Sphere не теоретическая
На странице проекта указано, что команда Nova Sphere внедрила кастомный фильтр товаров вместо ранее использовавшегося базового фильтра Битрикс, а также продолжила поддержку и оптимизацию проекта.
Посмотреть кейс →Большой каталог с более чем 160 000 товаров, более 1000 свойств товара и региональной структурой — пример масштаба, на котором фильтр и SEO должны проектироваться вместе.
Посмотреть кейс →Дополнительно Nova Sphere работает с 1С-Битрикс с 2015 года; на сайте опубликованы сертификаты и статусы партнёра, включая компетенции по интеграции и платформе. Это важно не как «SEO-фактор сам по себе», а как подтверждение того, что технические рекомендации основаны на практике разработки.
18. Чек-лист перед тем, как открыть SEO-фильтры для индексации
19. Практическая схема внедрения
- Собрать все свойства фильтра и все текущие форматы URL.
- Снять поисковый спрос и определить будущие SEO-посадочные.
- Создать реестр разрешённых комбинаций.
- Нормализовать ЧПУ и исключить перестановки параметров.
- Настроить robots / noindex / Clean-param для технических URL.
- Настроить метаданные и self-canonical для посадочных.
- Добавить посадочные в sitemap и внутреннюю перелинковку.
- Обработать нулевые и невозможные комбинации.
- Перестроить фасетные индексы.
- После выкладки контролировать логи и поисковые панели несколько недель.
Частые вопросы
Нужно ли закрывать весь /filter/ в robots.txt?
Нет, если часть ЧПУ-фильтров должна продвигаться. Полный Disallow отрежет и полезные посадочные. Лучше сначала разделить индексируемые и технические комбинации.
Можно ли просто поставить canonical на категорию у всех фильтров?
Только если страницы действительно являются дублями или очень близкими версиями. Для полноценной SEO-посадочной нужен self-canonical; для уникальной, но ненужной в поиске страницы понятнее noindex.
Достаточно ли включить ЧПУ в catalog.smart.filter?
Нет. ЧПУ делает адрес читаемым, но не решает проблему дублей, пустых сочетаний, метаданных, canonical, sitemap и бесконтрольного количества URL.
Нужно ли индексировать комбинации «бренд + цвет»?
Не автоматически. Сначала проверяются спрос, ассортимент и возможность сделать страницу самостоятельной.
Что важнее: noindex или robots.txt?
Они решают разные задачи. robots.txt ограничивает обход, noindex запрещает участие страницы в поиске после того, как робот смог её прочитать.
Что делать с фильтром, который вернул 0 товаров?
Для заведомо бессмысленной комбинации — 404. Для стабильной SEO-посадочной, временно оставшейся без ассортимента, решение принимается отдельно: сохранить страницу, noindex или 404 в зависимости от вероятности возврата товаров и пользовательской ценности.
Нужен аудит фильтра и каталога на 1С-Битрикс?
Nova Sphere может проверить текущие URL фильтра, индексирование, фасетные свойства, canonical, sitemap, технические параметры и архитектуру SEO-посадочных — а затем внедрить изменения в самом проекте.
Источники и документация
- 1С-Битрикс: компонент «Умный фильтр»
- 1С-Битрикс: умный фильтр и фасетный поиск
- 1С-Битрикс: создание фасетных индексов
- 1С-Битрикс D7: Tools::process404
- Google: управление сканированием фасетной навигации
- Google: canonical и объединение дублей
- Google: URL-структура интернет-магазинов
- Яндекс Вебмастер: Clean-param
- Яндекс Вебмастер: настройка GET-параметров